早上七点四十的那个电话
去年冬天,一个做家居跨境的老板给我打电话,时间是早上七点四十。
他说他刚打开后台,三家店铺的曝光一起掉到了个位数——前一天还是四位数。三个店在同一个设备分组里,走同一个出口。
他问了两个问题:是不是被封了?现在能不能改配置?
我让他先别动,然后我们把顺序理了一遍:先确认账号还能不能正常登录,再看是全部设备异常还是集中在某几台,最后才决定动手的方向。那一次是限流不是封号,处置了四天,三个店都回来了。
如果那天他按第一反应去改配置,要花的时间估计不止四天。
这篇文章就是把那天讲的那套顺序写出来。站内已经有两篇讲「怎么防」的了:一篇讲 iOS 群控的防封思路,一篇讲手机批量自动化的风控规避,这篇不重复那些内容——它只回答一个问题:已经出事了,接下来该怎么办。
「怎么防」是事前设计,「怎么办」是事后处置。大多数人真正慌的那一刻,是打开中控发现一批账号的曝光掉到接近零——那时候你需要的是顺序,不是原理。
先说一句:不同平台的判定机制各不相同,所以下面给的是判断依据和处置顺序,不是针对某个平台的固定步骤。你要做的是把这套顺序套到自己的场景里。
第一步:先分清是限流还是封号
这两个词经常被混着用,但处置完全不是一回事。
限流的表现是:账号还能登录、还能发内容、接口也不报错,只是没人看。数据上就是曝光、播放、触达量集体掉到很低的水平,有的平台会给一个模糊的提示,有的什么都不说。
封号是登录本身被拒。这个判断很直接,不用猜。
为什么要先分这一下?因为限流的处置还有回旋余地,封号基本只能走申诉。而且限流往往是封号的前一步——如果把它当成「最近流量不好」放几天再看,很可能就走到第二步去了。
所以发现数据异常的第一件事,是随机抽几台设备、几个账号,确认登录和发布功能是否正常。这一步花五分钟,但决定了后面所有动作的方向。
第二步:全部停手,不是只停出问题的那几台
这是最反直觉、也最重要的一步。
人的本能是「先救出问题的那批」,所以会立刻去调出问题设备的配置、换网络、改参数、重跑任务。这个动作会把两种情况同时搞砸:
一是扩大特征。处置期间的操作本身也是操作,如果根因还没找到,你在异常设备上的每一步都可能在加深问题。
二是毁掉对照组。你手上最有价值的东西,是那些还没出问题的设备——它们是你判断「问题出在哪」的唯一参照。如果一边排查一边继续跑,等回过头来,干净的那组也已经脏了,你就再也没法归因了。
所以正确的顺序是:先全停,再记录,最后才动手。
记录什么?至少四样:
- 出问题的时间点,以及数据开始下滑的时间点(这两个往往不是同一个)
- 涉及哪些设备和账号,范围是全批还是集中某几台
- 当时正在跑什么任务、用的什么配置
- 最近一次改动是什么时候、改了什么
最后那一条经常是答案所在,但也是最容易被忽略的——因为大家默认「昨天还好的」。
第三步:按设备隔离,不要按账号隔离
隔离的对象选错了,后面所有判断都会偏。
应该按设备分组。 原因是你的操作行为、网络出口、设备环境是绑在设备上的。同一台设备上的几个账号,表现通常是一致的;同一个账号换到另一台设备上,往往是好的。
按设备分组之后,你会很快得到一张表:
| 分组 | 表现 | 初步推断 |
|---|---|---|
| A 组设备 | 全部异常 | 设备或网络侧 |
| A 组中的个别设备 | 异常,同组其他正常 | 单机问题(线材、接口、环境) |
| 全批设备 | 都异常 | 大概率是内容或操作模式,不是硬件 |
| 只有某类账号的设备 | 异常 | 账号体系或来源问题 |
按账号分为什么容易错?因为账号会流动——今天在 A 组设备上跑,明天可能被分到 B 组。你按账号划范围,划出来的是一张网,不是一个圈。
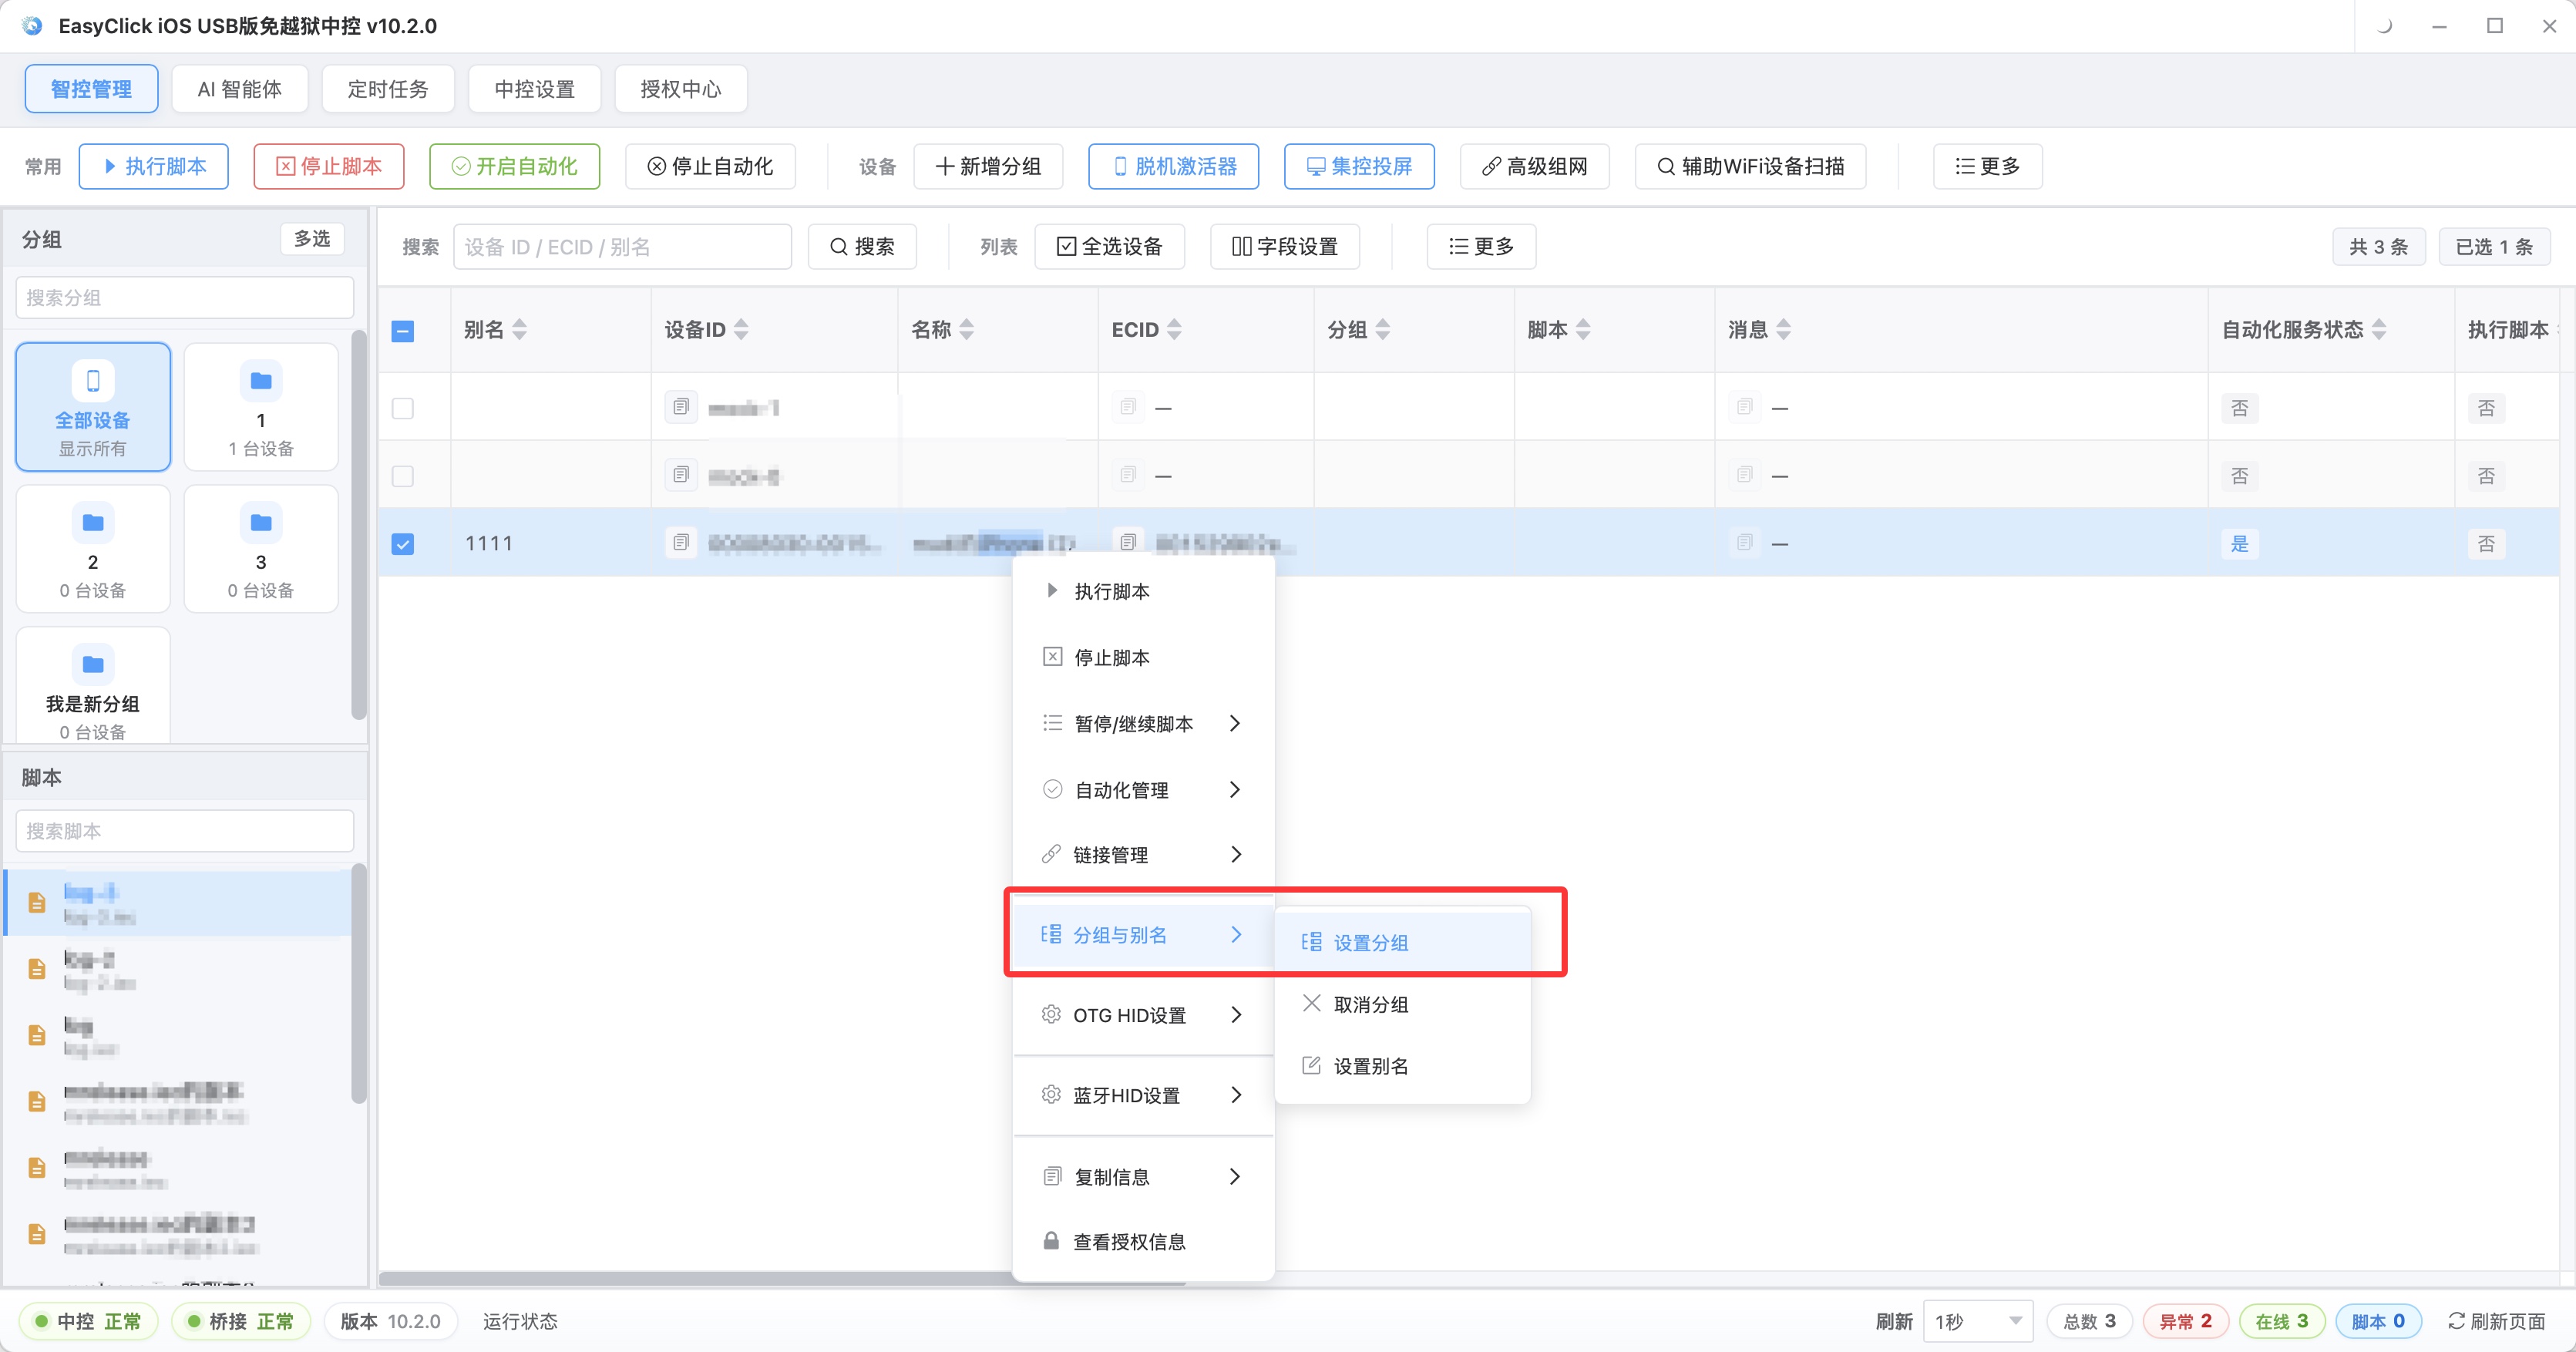
图里这种按用途和分组排好的设备列表,出事时就是你划分隔离范围的基础。分组越早做,处置越快。
第四步:找对照,判断问题出在设备网络还是内容
判断的依据不是猜测,是对照实验。三个最简单的对照:
- 同一批内容,发在没出问题的设备上。 正常 → 问题偏向设备或网络;同样异常 → 问题偏向内容或操作模式。
- 同一网络下的设备,表现是否一致。 集体异常 → 问题偏向网络出口;只有部分异常 → 问题在设备本身。
- 最近改过配置的设备,是不是异常更集中。 如果是,答案基本就在那次变更里。
这一步有个前提:你必须有没动过的干净设备。这就是第二步强调「全部停手」的真正原因——停手不只是止损,是在保护你这个唯一可靠的参照。
顺便说一句,这也是我建议平时保留一小批「低强度账号」的原因。它们平时跑得不多,但在这种时候就是你唯一能用的对照组。
第五步:恢复要分批,不能一次放开
处置完了,最容易出问题的是恢复阶段。
一次全放开,等于把处置期间攒下的所有待办操作,在同一时间点全部释放出去。 这制造出的操作密度,会比出事之前更异常。结果就是刚恢复两小时,又来一轮。
稳妥的做法是分三到四批:
- 第一批只放影响面最小、账号权重最稳的那几台,观察一个完整的业务周期(比如一整天)
- 确认没有再次触发,再放第二批,规模可以稍大
- 每一批之间保留观察窗口,并且恢复期间的操作密度要低于出事之前的日常水平,不要一上来就满负荷
- 如果某一批又出现异常,立刻停止放量,回到第三步重新归因
恢复期慢一点不丢人。急着恢复到满负荷,通常要用第二次事故来付学费。
恢复期最容易犯的三个错
第一,边排查边继续操作。 前面说过了,这是最常见的。着急的心态压过流程,最后线索全毁。
第二,恢复时用原班配置原样重放。 如果你的判断是「配置有问题」,那恢复时就该带上调整,而不是原封不动地跑回去。原样重放,等于重新触发一遍。
第三,没人去查最近改了什么。 事故处置最忌讳全员扑在恢复上。应该同时有一个人专门回溯:这批设备最近一周改过什么——系统的、网络的、脚本的、任务排期的。很多事故的根因就落在某一次看起来无关紧要的变更上。
最后
回到开头那个电话。那位老板后来跟我说,他那天最庆幸的事是没急着动手——因为当时他手上还有十几个干净的账号,正是后来拿去对比的那一组。
限流这类事故,绝大多数不是「突然发生」的,是某个变化累积到平台阈值之上的结果。所以处置的终点不是「恢复正常」,而是知道它是怎么被触发的。
留记录这件事不要省。出事时的笔记,是你下次遇到同类问题时唯一的参照——包括四样:时间点和现象、涉及的设备账号、当时的配置任务状态、做了哪些处置以及之后的变化。
站内另有两篇讲预防和边界,顺序上建议先读它们:苹果群控防封指南 和 手机批量自动化怎么避免风控。合规红线那一篇也很值得看一眼:手机群控合规指南。
无论如何部署,请确保使用场景本身合法合规。技术是中性的,边界在用法上。
关于 EasyClick:手机自动化 AI 智能体平台,覆盖安卓免 root、iOS 免越狱、鸿蒙 Next 三大生态,提供脚本开发、苹果群控、本地中控投屏与云控系统。→ 了解全部产品
想要真实跑起来?
本文介绍的方案均可在 EasyClick 手机自动化平台落地。官网提供完整文档、开发工具与群控云控产品,免费体验。